翻车档案 No.01|一次亚砜前置的复盘
同一个目标分子,同一个工具给出了两条路线。
- 路线 1:硫醚一路保留,四步走完之后,最后一步用 Kagan 型不对称氧化(枯基过氧化氢 / DET / Ti(OiPr)₄)生成手性亚砜,收率 95%。
- 路线 2:第二步就把硫醚氧化成亚砜(92%),随后带着这个亚砜,依次完成 CuI 参与的三氟甲基化、卤素–金属交换后羧基化、酰氯–酰胺缩合。
图 2 把整条路线中对条件最敏感的一步,放在了最前面。
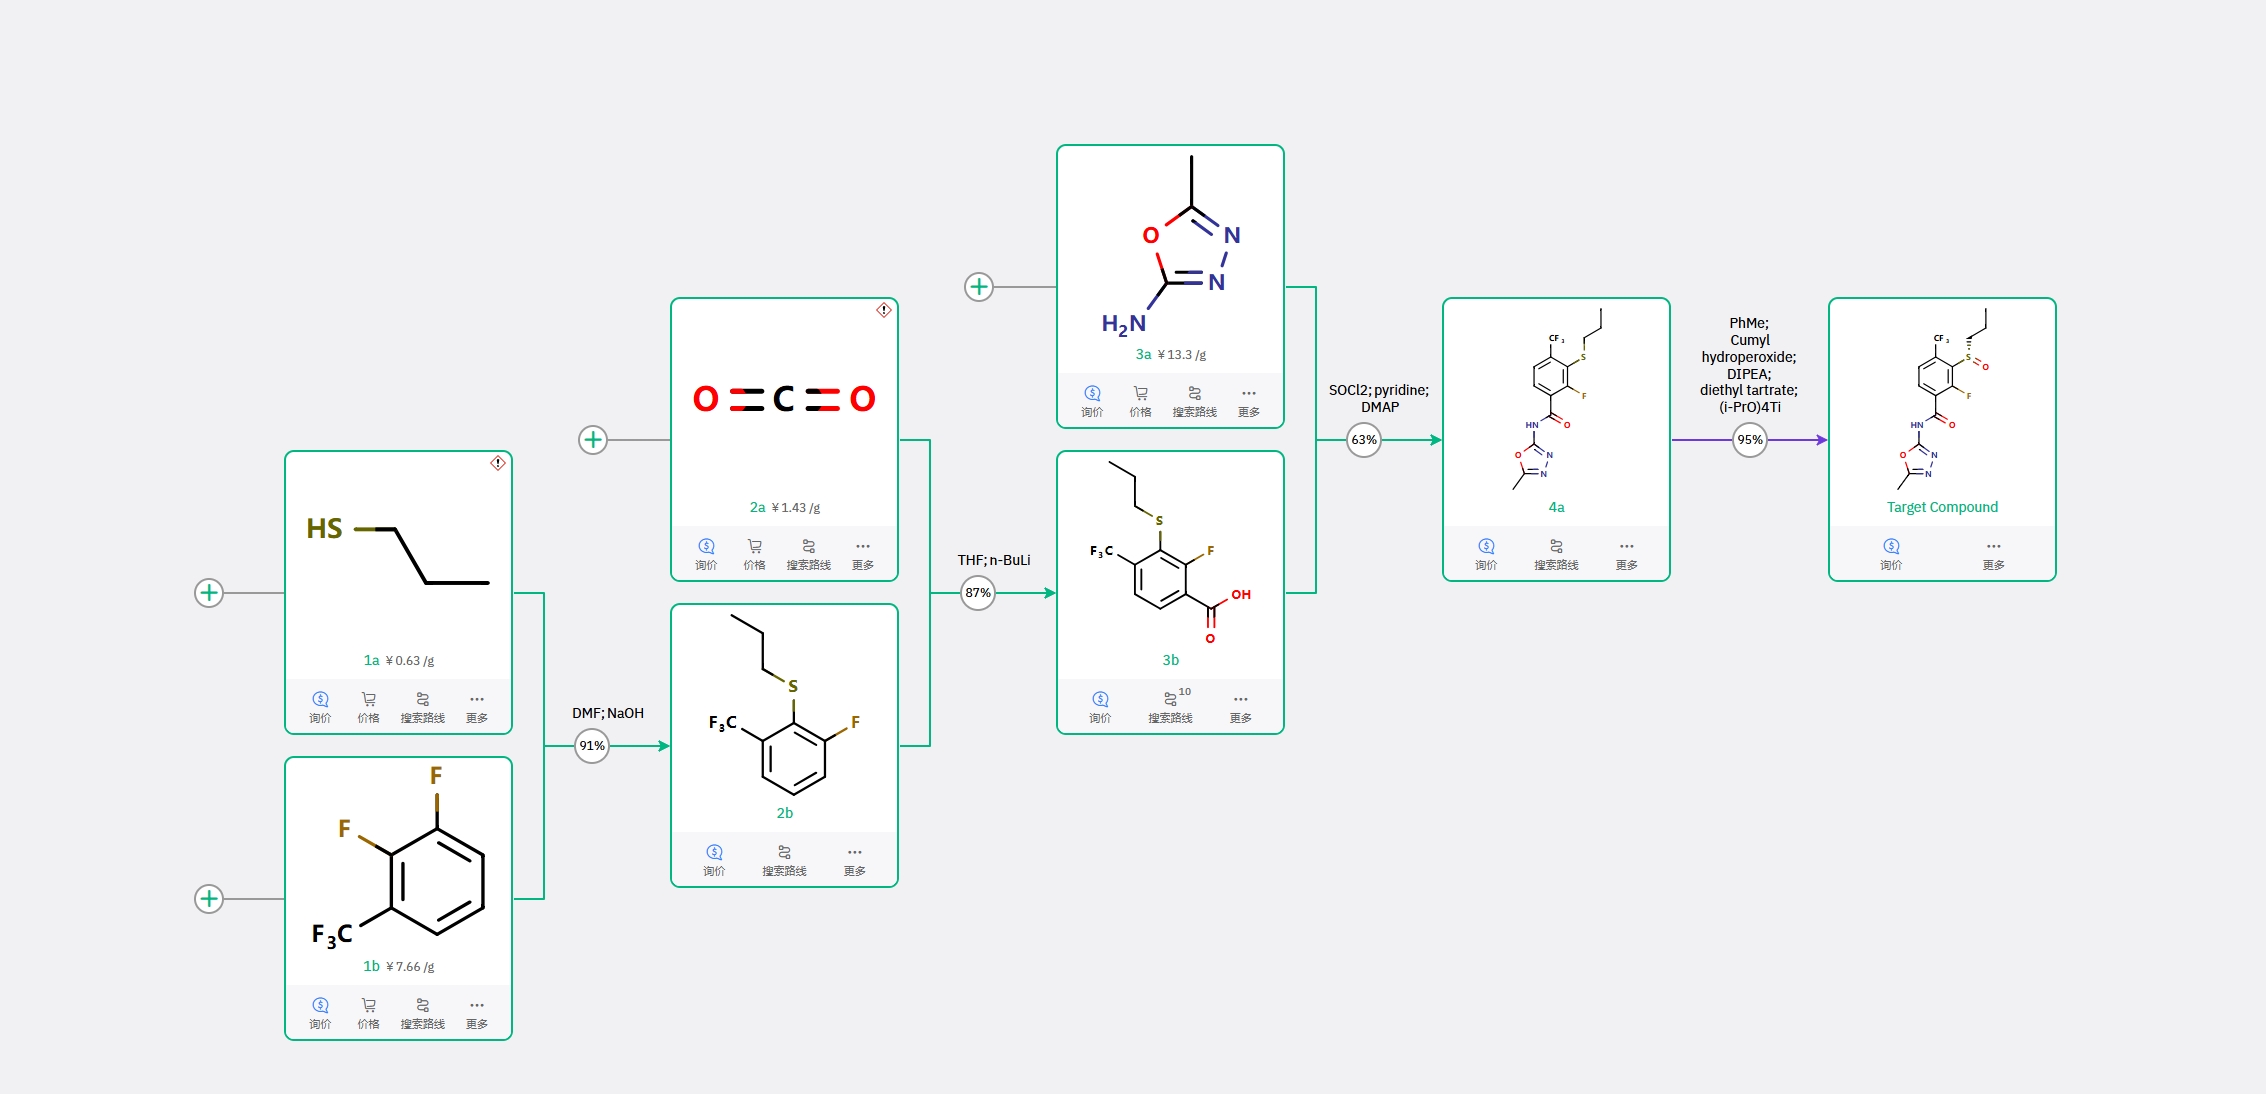
路线一
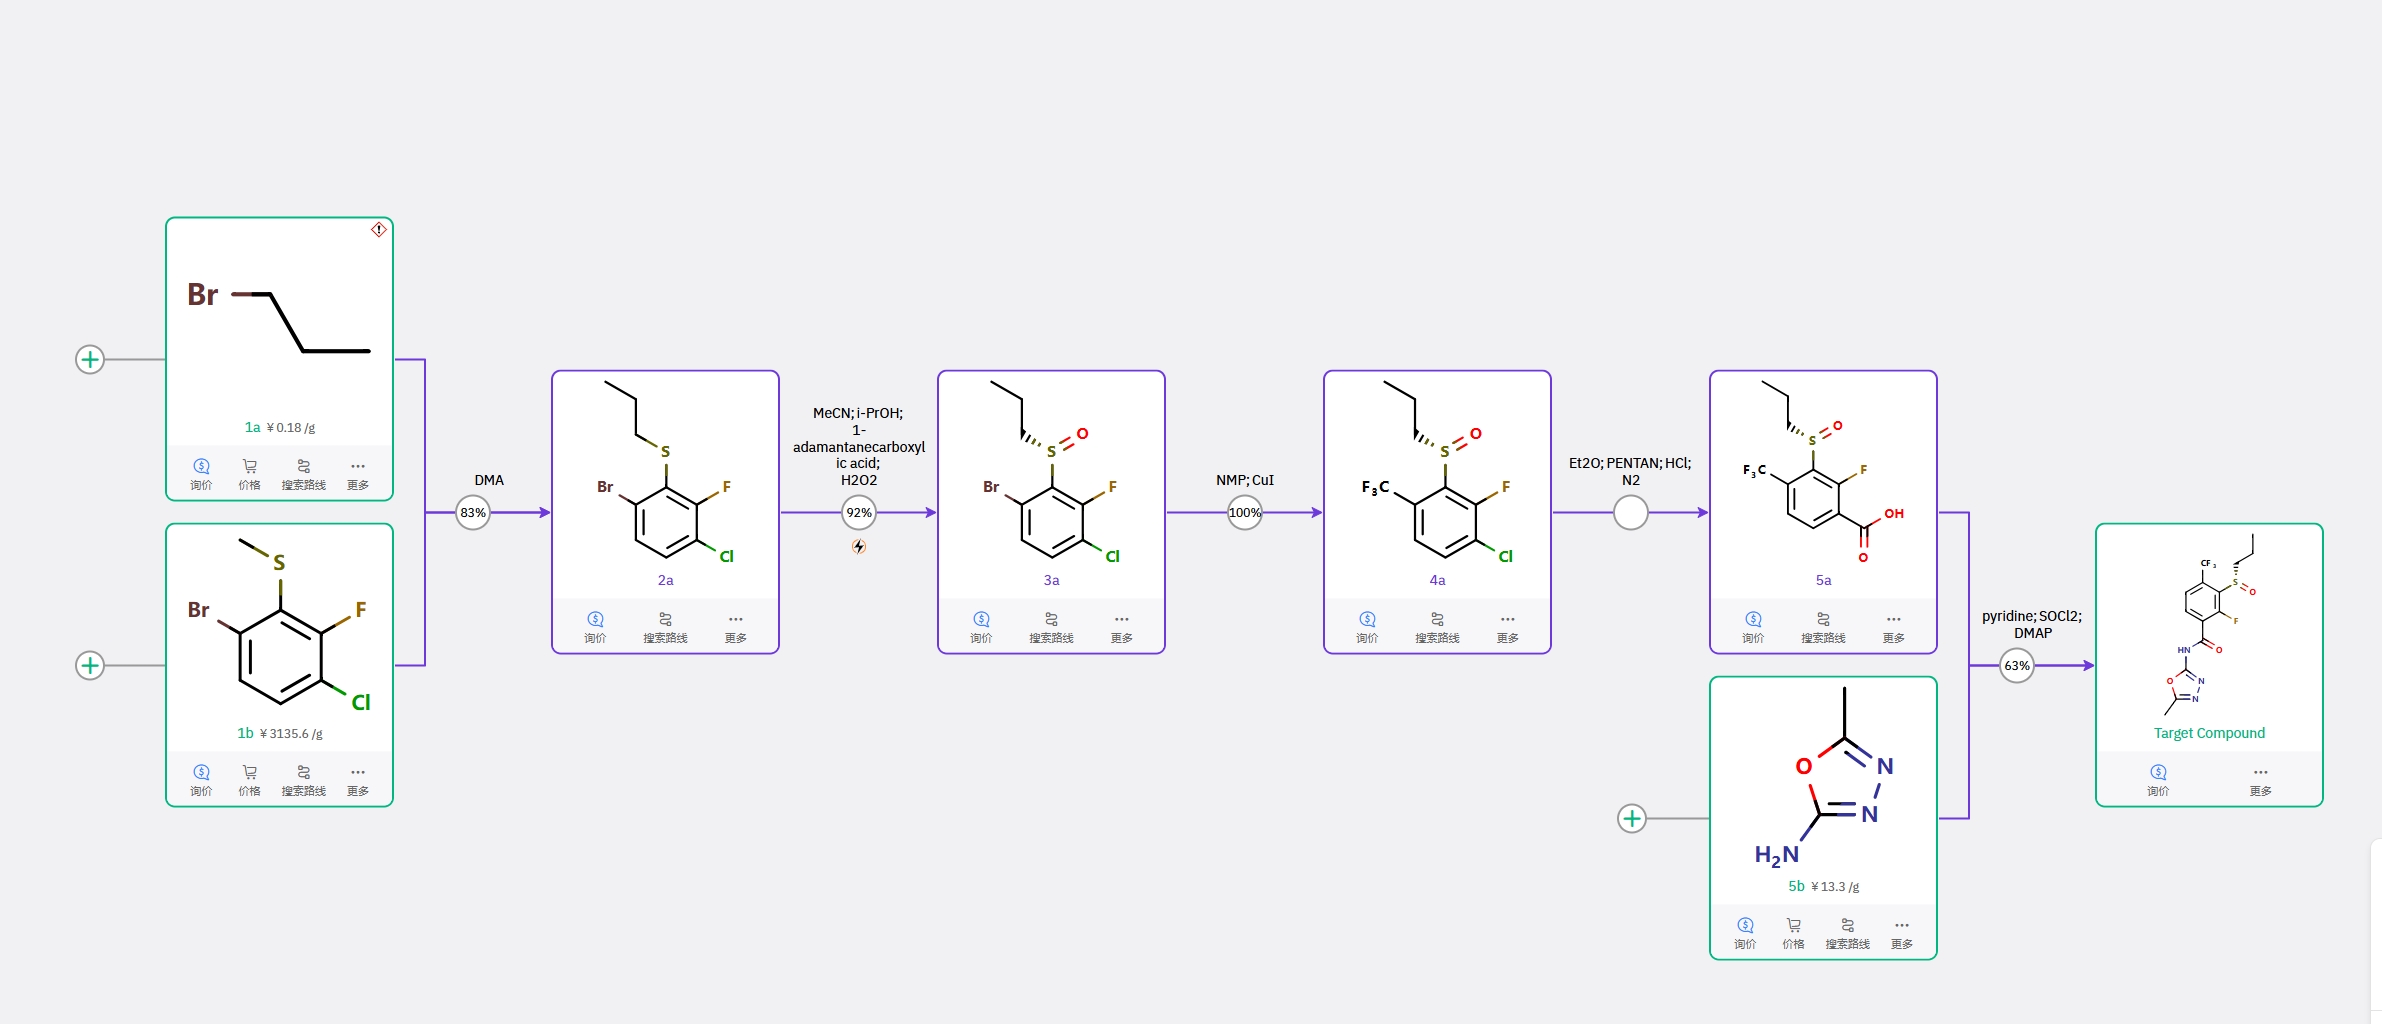
路线二
01 AI 为什么会犯这个“错”?
2.1 AI 的教科书式逻辑
AI 的推理并非毫无章法:目标分子含有亚砜 → 需要氧化步骤 → 氧化是成熟反应(文献收率 92%)→ 尽早引入关键官能团有利于后续步骤规划。
这个逻辑在理想实验室条件下成立。问题在于 AI 对官能团耐受性的理解,还停留在反应类型匹配层面,缺乏对全路线化学环境的动态评估。
2.2 化学家的真实担忧
让我们看看图二中,那个提前镀金的亚砜(化合物 3a)要经历什么:
风险点 1|第 4 步:在亚砜旁边做强碱 Et₂O/戊烷体系下的卤素–金属交换,本身就需要低温、控制当量;而底物上还挂着一个亚砜。亚砜的 α-H 会被强碱先行夺取,质子回捕后构型翻转。同时 S=O 会与芳基锂配位,实际消耗的碱量高于理论当量。
风险点 2|第 3 步:高温偶联,亚砜热稳定性存疑
风险点 3|第 5 步:SOCl₂ 与亚砜共存,可能氯化或还原亚砜
更关键的是选择性风险:步骤 3 的 CuI 偶联需要在氮气保护下进行,说明底物对氧化敏感;而步骤 4 又引入 HCl 酸化——氧化态在这种环境下极不稳定,可能产生砜(过度氧化)或回到硫醚(还原),甚至发生 C-S 键断裂。
02 AI 为什么会犯这个错?
- 它评估的是单步可行性,不是路线的脆弱性 逆合成的打分按单步设计:模板匹配度、文献支持度、原料可得性、参考收率。这些量是局部的、可加的,整条路线的分数也就按可加方式聚合。但路线风险不可加——亚砜在第 2 步是产物,在第 3、4、5 步是底物的一部分。“底物上已有的官能团会与条件冲突”需要一张显式的官能团–条件不相容矩阵,而多数模型里这只是一层隐式的软权重。
- 失败不进训练集 文献里亚砜共存下完成某反应的例子并不少,因为能被发表的都是成功的;失败的、消旋的、产率只有 20% 而后被放弃的,留在实验记录本里,不会成为训练数据。发表偏倚让模型对亚砜的先验天然乐观。
- 它偏好每一步都标准的路线 图 2 的五步都是常见反应类型:烷基化、硫醚氧化、CuI 三氟甲基化、卤素–金属交换、酰氯–酰胺缩合。模板覆盖率漂亮、每步都有据可查,总分自然高。每一步都正确,整体却不可行,这是逆合成模型最典型的失效模式:它优化的是单步可信度,不是整条路线的容错度。
- 它缺少顺序这一层知识 模型的默认倾向是尽早把目标官能团装配上去,再统一处理后续;化学家的默认倾向是——最脆弱的官能团最后引入,最危险的步骤最后执行。这不是知识量的差距,而是排序原则的差距,而排序原则几乎没有对应的训练信号,它只能来自“做过、翻过车、记住”的经验。
03 路线一为什么是更合理的答案
最脆弱的官能团最后生成。 硫醚在这条路线里不只是待氧化的前体,它还参与化学:n-BuLi 邻位金属化那一步,硫的孤对电子可提供配位辅助,帮助定位。带着它走完全部四步,等所有苛刻条件结束,再用枯基过氧化氢 / DET / Ti(OiPr)₄ 一步氧化到 95%——最后一步之后不再有化学反应,只有纯化。
04 路线二的适用边界
它并非一无是处。
毫克级、结构确证、时间紧的情况下,图 2 完全可以试,甚至可能更快:它避开了 SNAr 的区域选择性问题,也避开了对硫醚做邻位金属化的那条路径;手边有 LC-MS,亚砜是否变化可以监控。
但一旦进入克级、需要交付、要写进 SOP、要交接给他人,这条路线就不合适了。
图 1 和图 2 出自化合物智能规划平台。这个案例里,AI 并没有犯错——它给出了化学上可行的路线。但可行 ≠ 可接受,一线研发需要的是可放大、风险可控的路线。我们把这个翻车现场晒出来是想说我们的团队懂化学,也懂化学家的担忧。AI 是工具,不是黑箱。